Dime Dime Baby AI 视频
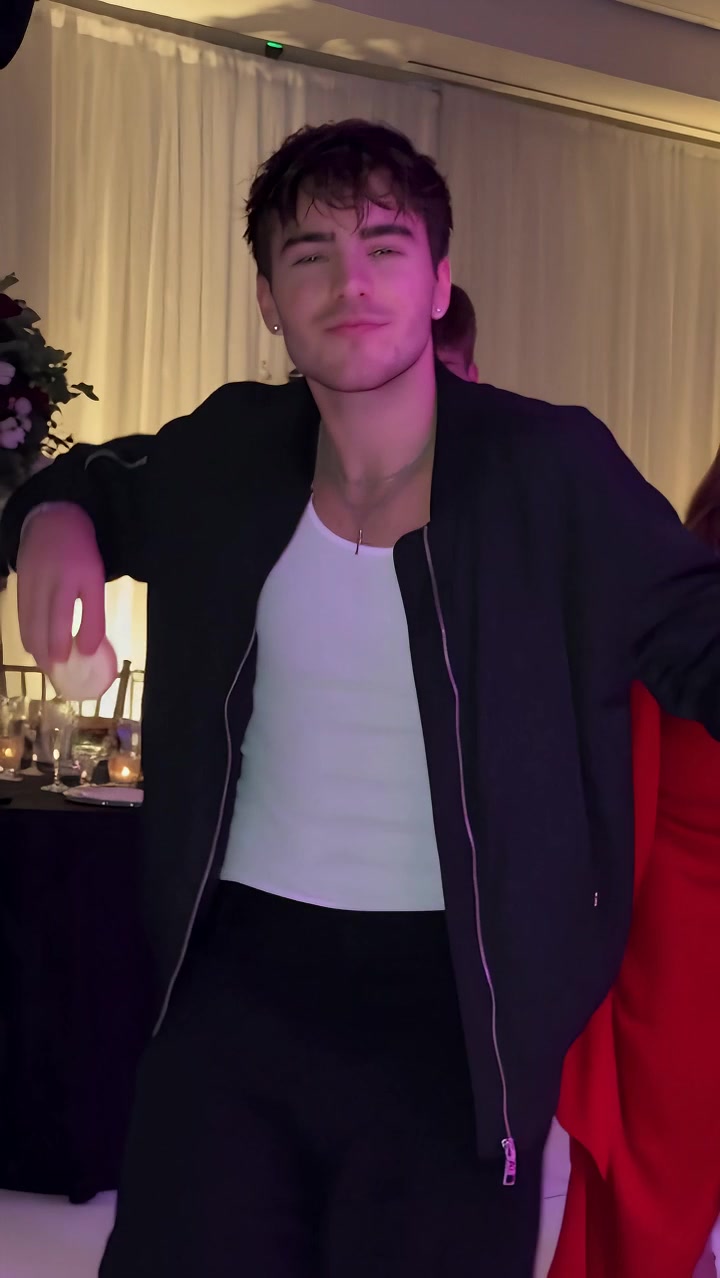
用1张人物照片生成9秒Dime Dime Baby AI视频。主角跳着碎步靠近,举起小糕点咬一口,咀嚼后转身走回宴会舞池,配上本效果的原片声音。
请选择单人、正面、光线清晰的照片,露出完整脸部和上半身效果更好。
因技术问题生成失败,已扣除的积分会自动退回。
加载中…
请使用你有权使用的照片及人物形象。
视频预览
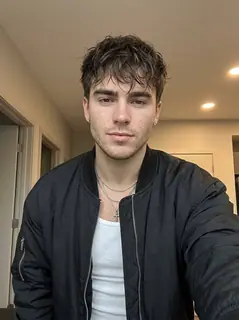
上传照片,开始你的故事
当前展示效果预览,生成完成后将在这里显示你的成片。
试试更多热门视频玩法

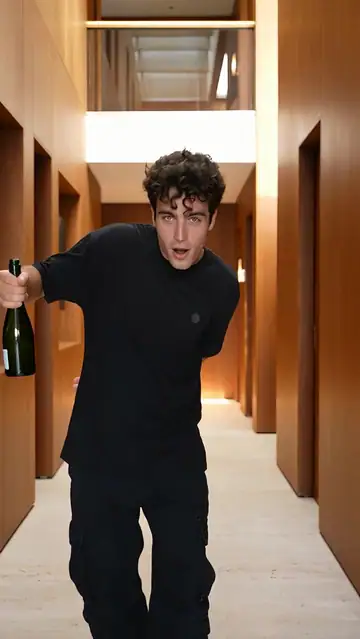
什么是 Dime Dime Baby AI?
Dime Dime Baby AI把一个小趣味融进宴会舞步:主角朝镜头碎步靠近,咬一口小糕点,边咀嚼边保持身体节奏,再转身走回舞池。点心和手到嘴边的动作属于同一条连续表演,不是另外切出的进食特写。
- 照片决定什么
- 1张人物照片决定前景舞者的五官、发型和原有衣着。后方宾客保持独立人物,不使用照片把整个人群换成同一张脸。
- 动作和背景
- 参考样片的动作与场景重新生成整段视频。背景、镜头、表情和遮挡可能变化,不保证逐帧一致。
照片到视频:配对案例
对照输入原图与对应视频,了解主角外观和实际动作。
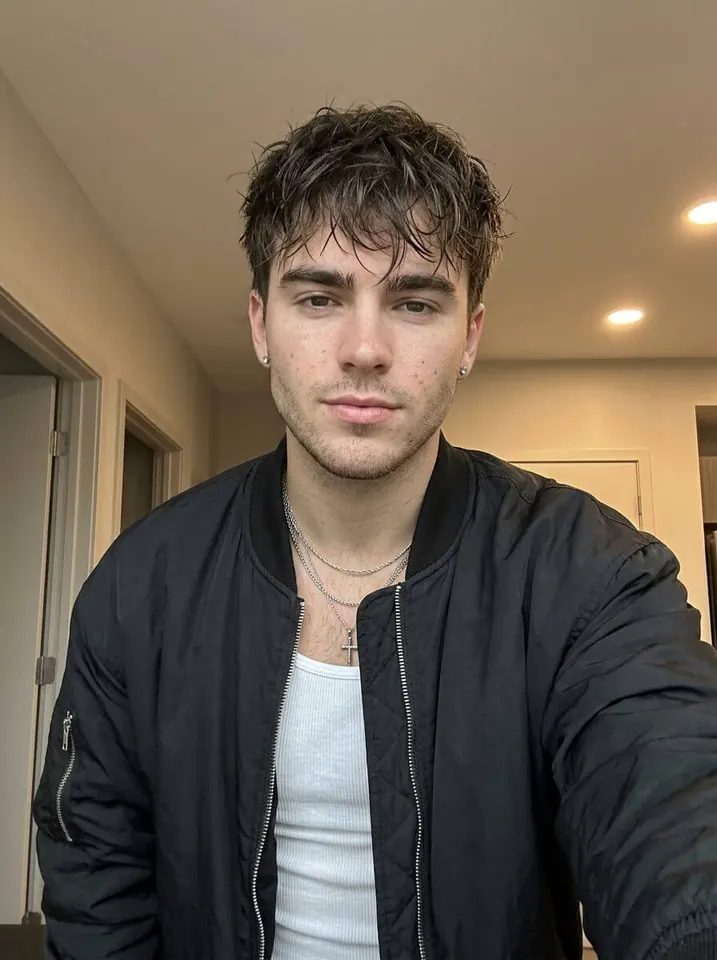
这个视频会出现什么动作?
从本模板展示视频中提取的三个节点,帮助你了解画面和表演方式。
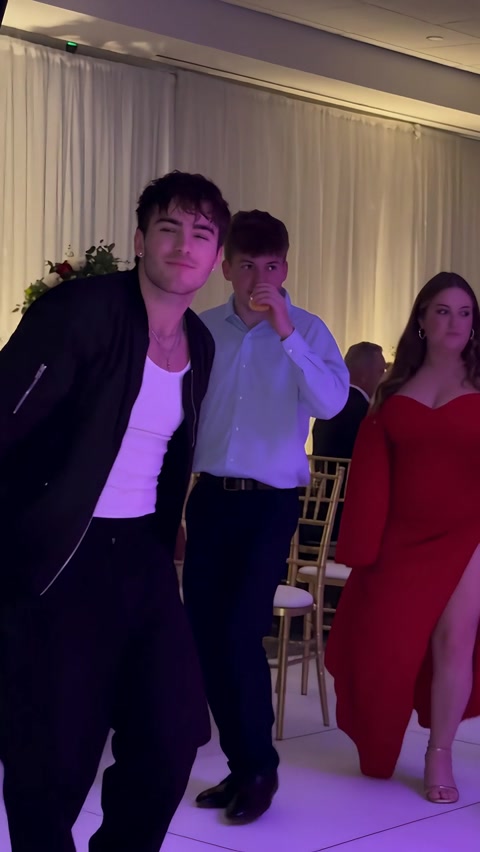
01 · 开场 拿着点心碎步靠近
主角以短距离交叉步走近镜头,一只手逐渐举起小糕点。
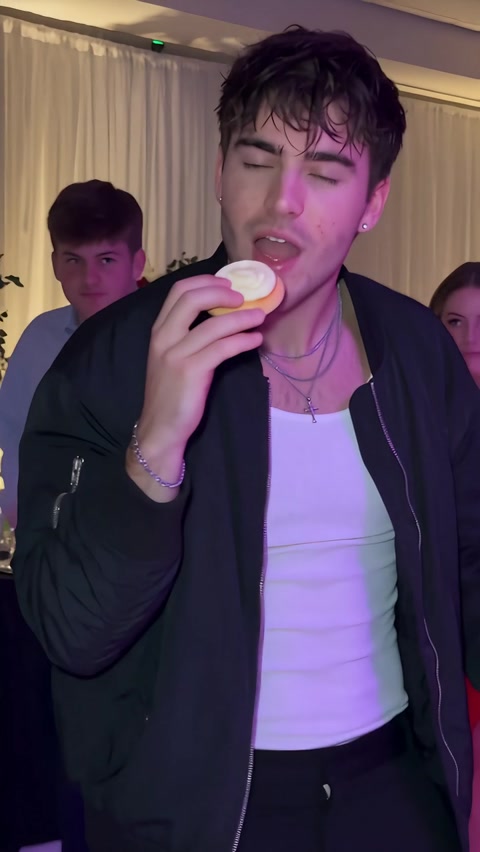
02 · 中段 咬一口,继续节奏
主角咬下一小口后放低手,轻松咀嚼并俏皮地看向镜头。
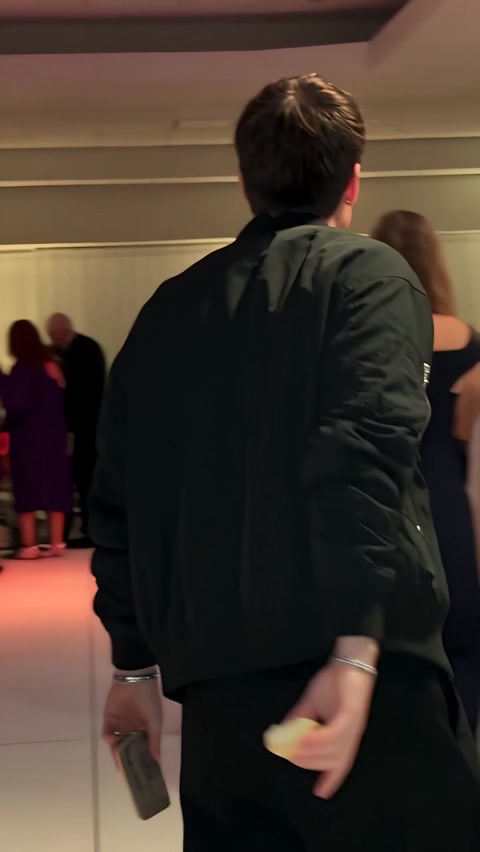
03 · 后段 转身走回宴会人群
舞者从侧身转到背身,轻松摆臂并沿舞池走开收尾。
如何获得更好的生成效果?
推荐上传
- 单人脸部清晰,嘴部和手部没有明显遮挡
- 光线均匀、画面清楚,包含上半身或更多身体轮廓
- 光线均匀,细节清楚
- 主体轮廓与背景容易区分
尽量避免
- 拼图、聊天界面或带水印的截图
- 手挡嘴部、多人合照或厚重的面部遮挡
- 期待精确复制每一口咬合形状或原片全部宾客
- 模糊、过暗或重度滤镜
效果不理想时,可以这样调整
- 外观不够像
- 先检查不同镜头中脸部、发型或毛色是否漂移。提高分辨率不等于锁定身份;可对照上方照片建议换图,每次重试仍会消耗积分。
- 肢体或道具衔接异常
- 暂停检查手脚、前爪与道具的接触位置。模型可能在遮挡和快速动作处补错结构,当前页面没有局部修复;更高画质不能保证修正解剖错误。
- 角色或前后关系混淆
- 本效果只为一个主角分配照片。配角、鬼影或背景动物不需要额外上传;若身份跑到配角身上,属于生成偏差。
- 动作或表演有偏差
- 手指、咬合、糕点边缘和咀嚼可能不稳定,转身时也可能出现衣着漂移。生成的宾客与灯光不保证和原片完全一致。
- 任务显示生成失败
- 先在“我的视频”确认任务状态。技术失败会自动退回已扣积分;生成成功但不符合个人预期是不同情况。每次重新生成都需要积分,请先查看退款政策。
三步制作 Dime Dime Baby AI 视频
- 步骤 01
上传照片
选择一张清晰的单人照片。
- 步骤 02
生成同款视频
选择 480p / 720p / 1080p 画质,确认积分后提交。当前输出为 9 秒、9:16 画幅;处理期间可以离开页面,完成后到“我的视频”查看。
常见问题
Dime Dime Baby AI需要几张照片?
需要1张单个人物照片。保持脸部和嘴部可见,身体轮廓清楚,有助于舞步、咬点心和转身过程中延续同一主角。
上传照片里一定要拿着食物吗?
不需要。小糕点由模板场景提供。相比手挡住嘴部的照片,清楚、自然、没有明显遮挡的人像更适合作为输入。
什么样的照片效果更好?
一张清楚的单人照片查看适合本效果的照片建议 ↓
它和Bby Wow AI是同一段舞蹈吗?
这是独立的9秒动作:咬点心、咀嚼,再背向镜头走开。Bby Wow是更长的转身回到镜头前的表演,两者使用各自的深度参考与原片声音。
生成后会保留照片里的外观吗?
照片为主角提供身份与外观参考,并非复制原视频像素。脸部、发型、毛色和衣着可能随动作改变;盔甲等特殊装扮按本页介绍生成。
会生成多长、什么画幅的视频?
当前模板输出 9 秒、9:16 画幅的 MP4,可选画质为 480p / 720p / 1080p。所需积分以生成按钮上的实际报价为准。
生成的视频有音乐或声音吗?
有。成片会使用这个模板的原片音轨,包括其中已有的音乐、歌声或现场声;照片里的主角不会另外录制一套演唱声音。