
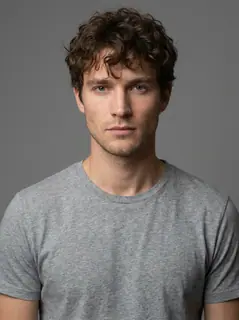
上传照片,开始你的故事
当前展示的是效果预览。生成进度和成片可在「我的视频」中查看。
使用这个模板加载中…
Give It All to Me AI 视频
正在恢复草稿…
- 预计生成时间
- 5–15 分钟
- 所需积分
- 加载中…
因技术问题生成失败,已扣除的积分会自动退回。
完成后,MP4 视频会保存在「我的视频」,可在那里播放和下载。
加载中…
请使用你有权使用的照片及人物形象。
试试更多热门视频玩法
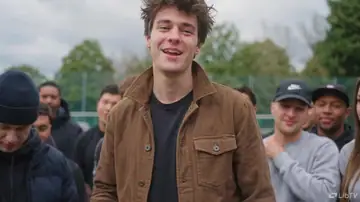
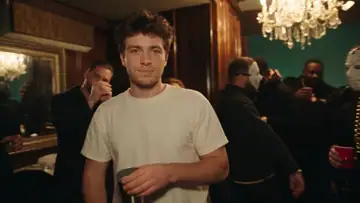
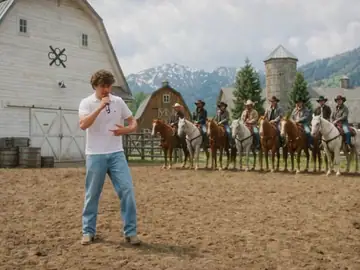
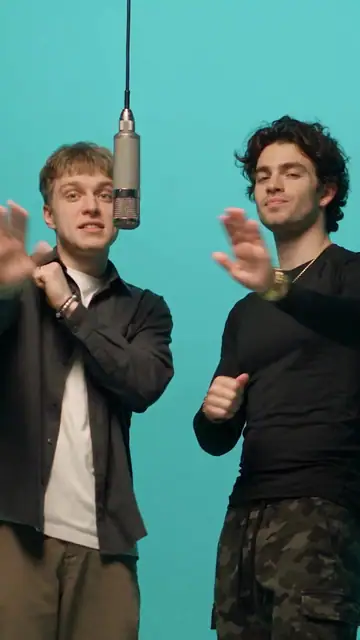
什么是 Give It All to Me AI?
Give It All to Me AI 将一张人物照片变成 12 秒单人说唱表演。画面沿用参考片段的夜间影院大厅、银色悬挂麦克风、橙色灯光和后方人群,主角按节拍摆动手臂、转身并朝镜头做手势。上传照片决定前景人物外观,背景观众保持独立身份。
- 照片决定什么
- 一张照片只控制悬挂麦克风前的主角,包括脸、发型、体型、服装和配饰;不会把后方观众也变成上传人物。
- 动作和背景
- 参考样片的动作与场景重新生成整段视频。背景、镜头、表情和遮挡可能变化,不保证逐帧一致。
照片到视频:配对案例
对照输入原图与对应视频,了解主角外观和实际动作。
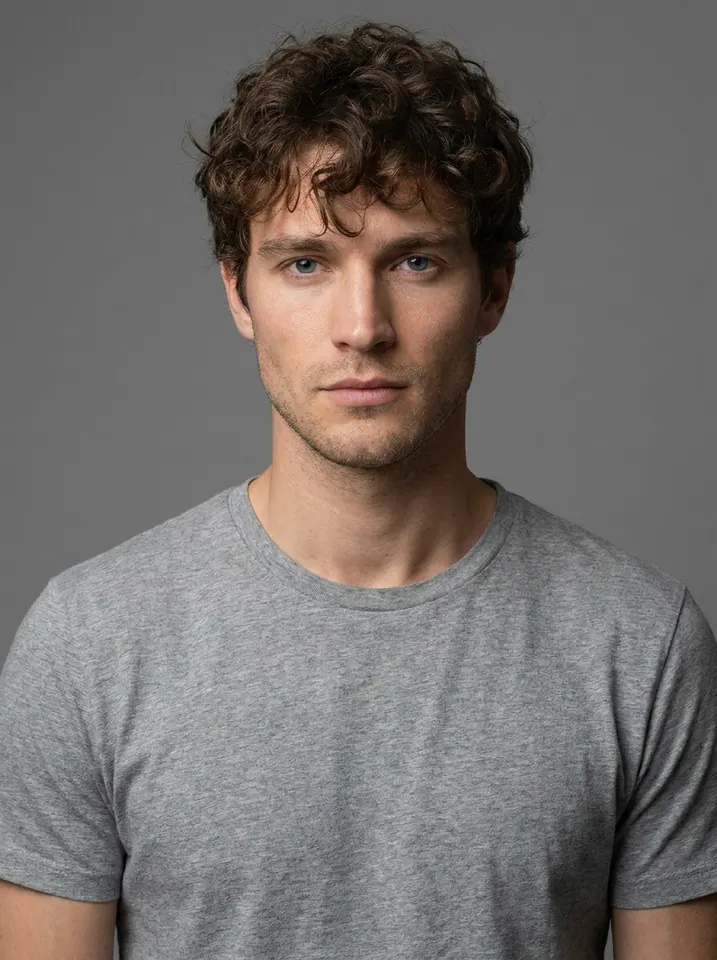
这个视频会出现什么动作?
从本模板展示视频中提取的三个节点,帮助你了解画面和表演方式。
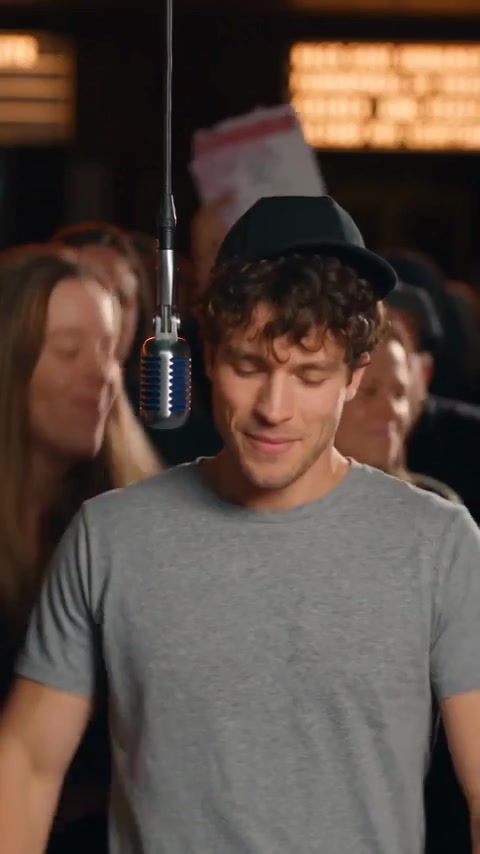
01 · 开场 在麦克风前随节拍律动
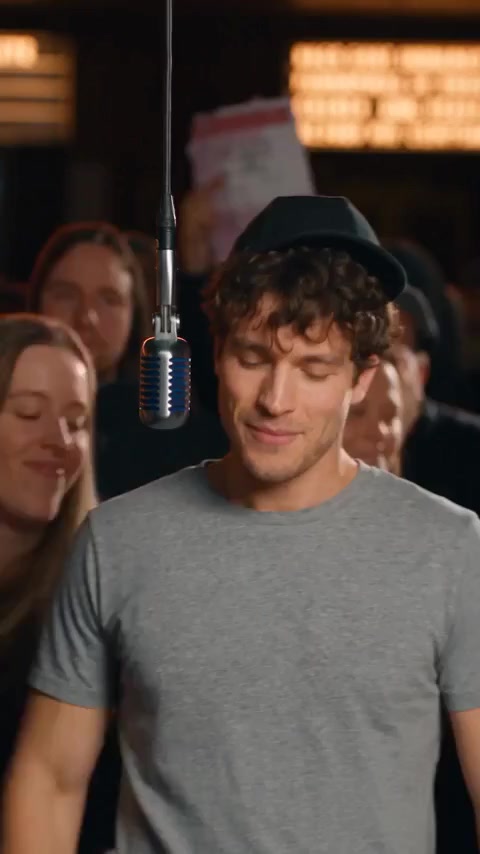
前景人物先低头微笑、左右律动,前臂在身前交替横摆,随后抬头面向镜头。
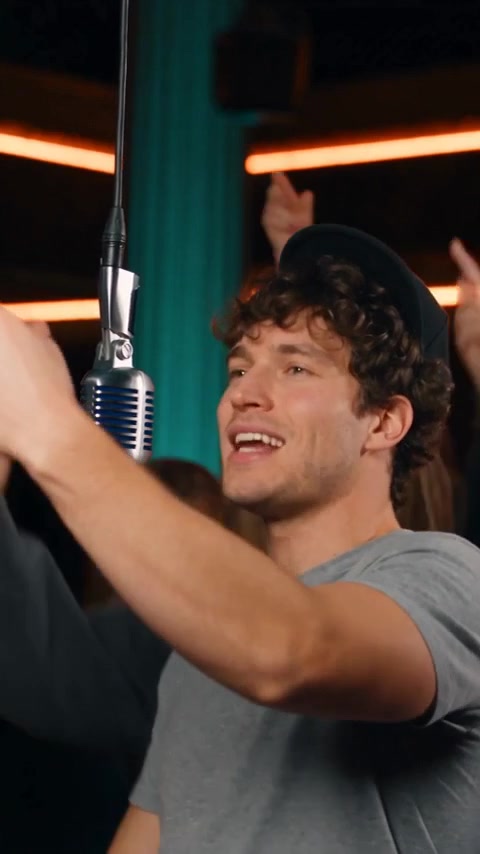
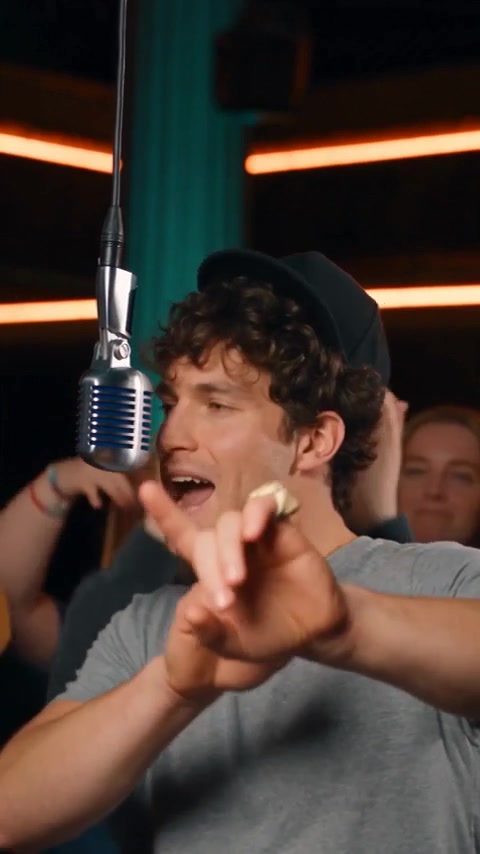
02 · 中段 侧身伸手并接唱
生成案例切换到侧前方,同一位主角在悬挂麦克风旁转身、伸手,后方人群随节奏呼应。
03 · 后段 朝镜头指点并收尾
同一人物向镜头转回,抬手、张掌和比划最后的词句,末尾保留短暂的侧面切镜。
如何获得更好的生成效果?
推荐上传
- 一张清晰、光线均匀的单人照
- 完整发型、清楚的面部、肩膀和上半身服装
- 光线均匀,细节清楚
- 主体轮廓与背景容易区分
尽量避免
- 拼图、聊天界面或带水印的截图
- 多人合影、面部过暗、重度滤镜和墨镜
- 手或手机遮嘴、头发被裁掉,以及紧挨主角的另一张脸
- 模糊、过暗或重度滤镜
效果不理想时,可以这样调整
- 外观不够像
- 如果脸、发型或衣服发生变化,请换用更清晰、光线均匀、完整展示头部和服装的单人照,避开强滤镜、暗脸和主角旁边的其他面孔。
- 肢体或道具衔接异常
- 动作包含身前交叉手臂、伸手靠近镜头及悬挂麦克风旁的转身。照片中应清楚展示肩膀和上半身,手不要遮脸,尽量避免服装或肢体被大幅裁切。
- 角色或前后关系混淆
- 唯一上传位置只属于前景主角。请选择单人照;背景观众不能分别指定,也不应复制上传人物的脸。
- 动作或表演有偏差
- 快速说唱、靠近镜头的手、悬挂麦克风和侧面机位都可能影响面部细节与口型。提示词按原参考时间线约束动作,AI 成片的动作、人物相似度和人群细节仍可能有差异。
- 任务显示生成失败
- 先在“我的视频”确认任务状态。技术失败会自动退回已扣积分;生成成功但不符合个人预期是不同情况。每次重新生成都需要积分,请先查看退款政策。
三步制作 Give It All to Me AI 视频
- 步骤 01
上传照片
选择一张清晰的单人照片。
- 步骤 02
生成同款视频
选择 480p / 720p / 1080p 画质,确认积分后提交。当前输出为 12 秒、9:16 画幅;处理期间可以离开页面,完成后到“我的视频”查看。
常见问题
上传的照片会替换哪个人物?
只替换银色悬挂麦克风前的前景主角。后方观众保持不同身份,不继承上传人物的脸、发型或服装。
预览是由示例照片生成的结果吗?
当前预览是提供的生成案例,与上方灰色短袖人物原图配对展示。三个动作画面也截自这段成片,用于说明这一次的生成效果;更换照片或重新生成后,人物、服装和表演细节仍可能有差异。
会使用原演员的声音或克隆我的声音吗?
开头 3.5 秒保留参考片的背景音乐,包括旋律采样。进入说唱后,由模型生成新的主唱人声,再与本片伴奏混合。不会克隆你本人的真实声音,也不需要额外录音。
可以输入其他歌词,或给观众上传照片吗?
当前版本采用预设词句和固定 12 秒动作片段,只接收前景主角的一张人物照,不提供自定义歌词或观众选角控件。
生成需要多少积分?
费用取决于所选画质,请先查看生成按钮旁的实际积分报价。每次新生成都会消耗积分;可以购买一次性积分包,无需订阅。价格 ↗
视频有多长?支持什么比例和画质?
当前模板输出 12 秒、9:16 画幅的 MP4,可选画质为 480p / 720p / 1080p。所需积分以生成按钮上的实际报价为准。
生成失败会退还积分吗?
确认因技术问题生成失败后,已扣除的生成积分会自动退回。排队中或处理中不代表失败;如果任务长时间不更新或积分未退回,请携带任务编号联系支持。付款退款另行审核。查看退款政策 ↗
什么照片效果好?在哪里下载成片?
使用一张清晰、光线均匀的单人照,保留完整发型、面部、肩膀和可见服装,嘴部不要被手或物品遮挡。提交后在“我的视频”查看进度,完成后预览并下载 MP4。查看退款政策 ↗