
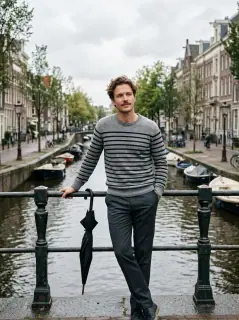
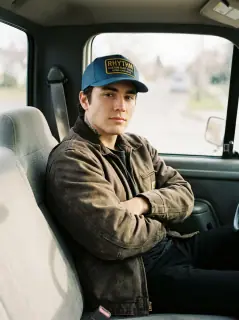
上传照片,开始你的故事
当前展示的是效果预览。生成进度和成片可在「我的视频」中查看。
使用这个模板加载中…
AI Old Town Road 视频
正在恢复草稿…
- 预计生成时间
- 5–15 分钟
- 所需积分
- 加载中…
因技术问题生成失败,已扣除的积分会自动退回。
完成后,MP4 视频会保存在「我的视频」,可在那里播放和下载。
加载中…
请使用你有权使用的照片及人物形象。
试试更多热门视频玩法
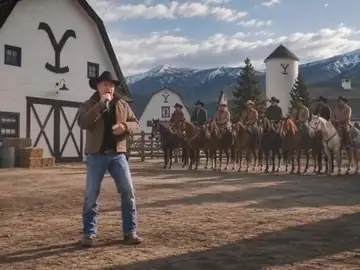
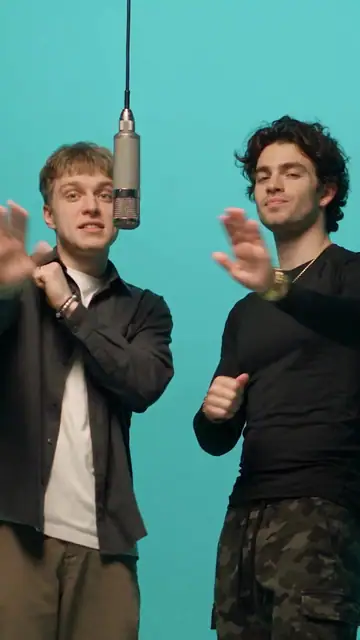
什么是 AI Old Town Road?
让两个人进入红色敞篷车音乐录像场景。驾驶者先在车窗旁出场,演唱者接过独立近景,最后两人在俯拍镜头中同框,汽车驶离画面。约14.7秒原片保持原有节奏,15秒输出仅在道路空镜末尾短暂延续。
- 照片决定什么
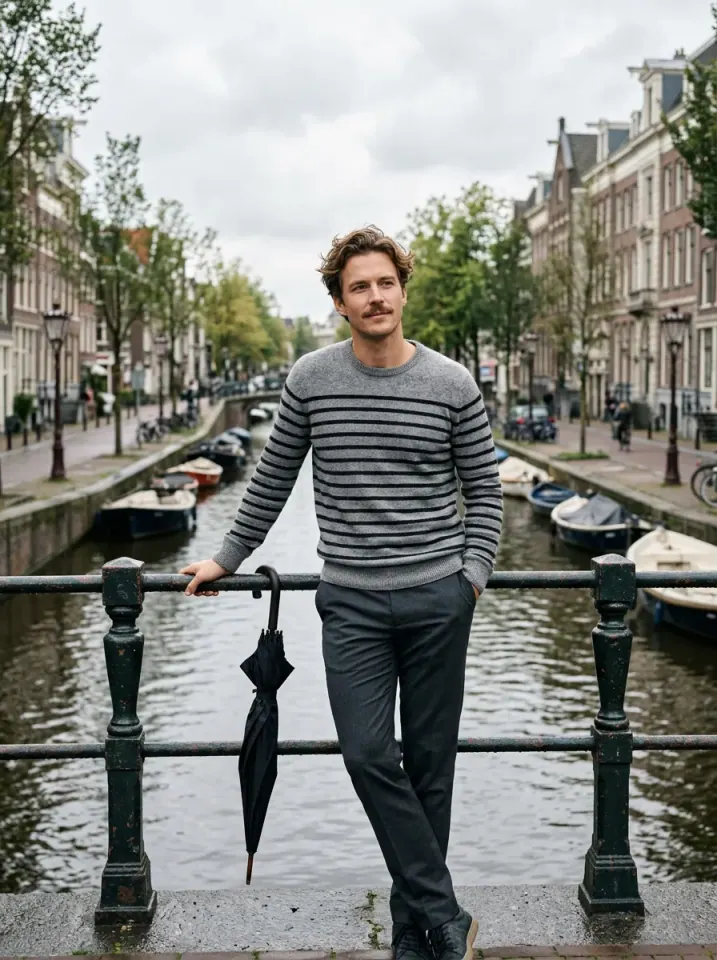
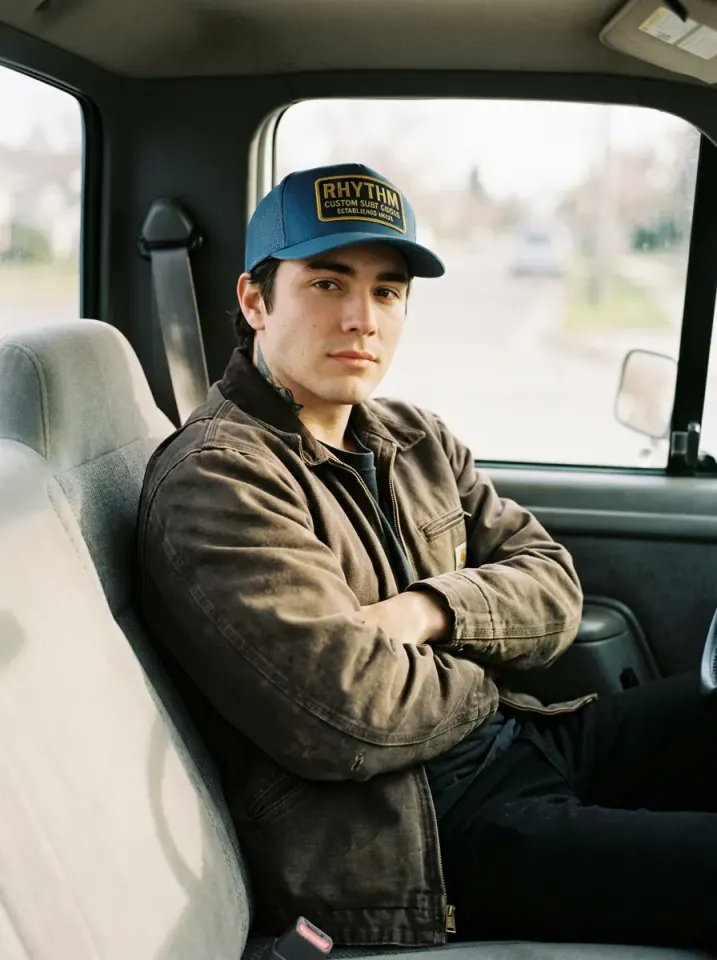
- 照片1控制方向盘前的驾驶者,包括开场致意和结尾俯拍。照片2控制所有独立演唱镜头的人物,以及结尾坐在副驾的人物。镜头角度变化不会交换照片对应关系。
- 动作和背景
- 参考样片的动作与场景重新生成整段视频。背景、镜头、表情和遮挡可能变化,不保证逐帧一致。
照片到视频:配对案例
对照输入原图与对应视频,了解主角外观和实际动作。
这个视频会出现什么动作?
从本模板展示视频中提取的三个节点,帮助你了解画面和表演方式。
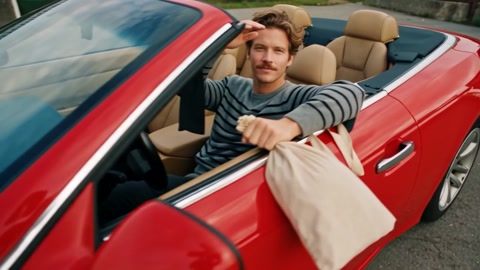
01 · 开场 驾驶者车窗出场
镜头沿挡风玻璃移向驾驶者,人物将前臂靠在车门上,再把另一只手抬到额头附近。
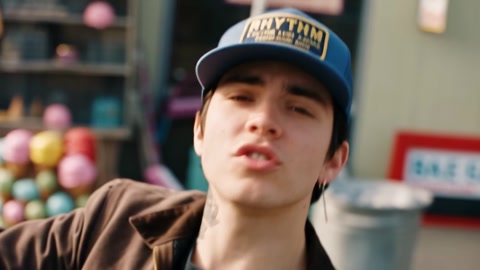
02 · 中段 切入演唱近景
副驾人物在彩色店铺背景前独自表演,点头并举起掌心,镜头从中近景切得更近。
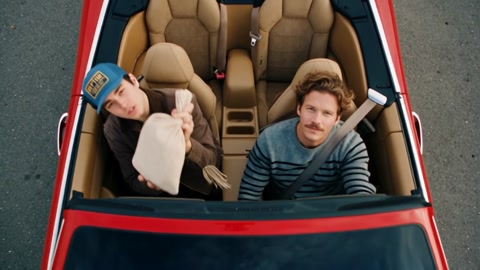
03 · 后段 敞篷车驶离
正上方镜头重新展示驾驶者与副驾,随后红车从画面中驶离,只剩道路空镜。
如何获得更好的生成效果?
推荐上传
- 上传两张独立、清晰的单人照,面部和发型清楚可见。
- 露出肩部和服装,帮助驾驶者完成抬手、演唱者完成掌心手势;按驾驶者在前、演唱者在后的顺序上传。
- 光线均匀,细节清楚
- 主体轮廓与背景容易区分
尽量避免
- 拼图、聊天界面或带水印的截图
- 多人合照、强滤镜,或被手机、深色墨镜、头发与阴影遮挡的脸。
- 过紧的面部裁切,导致服装、肩部或手臂信息不清楚。
- 模糊、过暗或重度滤镜
效果不理想时,可以这样调整
- 外观不够像
- 尝试光线均匀、头发清楚且面部无遮挡的独立肖像。驾驶者有侧面和俯视角度,演唱者会转头并靠近镜头,强滤镜和阴影会增加这些角度的难度。
- 肢体或道具衔接异常
- 尽量展示肩部、手臂和服装。驾驶者额头附近的手势、演唱者脸侧的掌心及手与钱袋接触较复杂,实际细节可能变化。
- 角色或前后关系混淆
- 核对驾驶者在前、演唱者在后的上传顺序。中段独唱近景必须使用照片2;照片1在开场和俯拍镜头中保持驾驶席身份。
- 动作或表演有偏差
- 参考用于引导手势、切镜和汽车驶离,嘴部动作、手部与相似度仍可能变化。原片节奏保持不变,只在道路空镜末尾短暂停留,使输出达到15秒。
- 任务显示生成失败
- 先在“我的视频”确认任务状态。技术失败会自动退回已扣积分;生成成功但不符合个人预期是不同情况。每次重新生成都需要积分,请先查看退款政策。
三步制作 AI Old Town Road 视频
- 步骤 01
上传照片
分别上传两张单人照片,并按角色顺序放入。
- 步骤 02
生成同款视频
选择 480p / 720p / 1080p 画质,确认积分后提交。当前输出为 15 秒、16:9 画幅;处理期间可以离开页面,完成后到“我的视频”查看。
常见问题
哪张照片是驾驶者,哪张是演唱者?
照片1是方向盘前的驾驶者,照片2是独唱近景中的演唱者,也是俯拍同框里的副驾。每张照片只放一个人;镜头变化时两人的职责不交换。
两人会保留自己的脸和服装吗?
每张照片分别引导人物的脸、年龄、头发、体型和可见穿搭。照片里没有的牛仔帽、墨镜、胡须和西部服装,不会在提示词中要求继承原演员造型。实际细节仍可能变化。
什么样的照片效果更好?
使用两张光线均匀的清晰单人照,露出眼睛、头发、肩部和服装。先上传驾驶者,再上传演唱者;避免合照及被深色墨镜或手机遮挡的脸。查看适合本效果的照片建议 ↓
预览是用户生成的结果吗?
是的,这是使用这里两张人物照片制作的生成案例:灰色条纹毛衣人物担任驾驶者,蓝帽棕外套人物担任演唱者和副驾。你自己的照片按相同顺序对应角色,实际生成细节可能变化。
生成后会保留照片里的外观吗?
第一张照片始终绑定驾驶者,第二张始终绑定演唱者,包括最后的俯拍同框。两人的原有五官、发型和穿搭分别引导生成,实际相似度无法保证。
会生成多长、什么画幅的视频?
当前模板输出 15 秒、16:9 画幅的 MP4,可选画质为 480p / 720p / 1080p。所需积分以生成按钮上的实际报价为准。
生成的视频有音乐或声音吗?
有。成片会使用这个模板的原片音轨,包括其中已有的音乐、歌声或现场声;照片里的主角不会另外录制一套演唱声音。